
Agentic AI
Tool Schema Bias for Agentic Environments
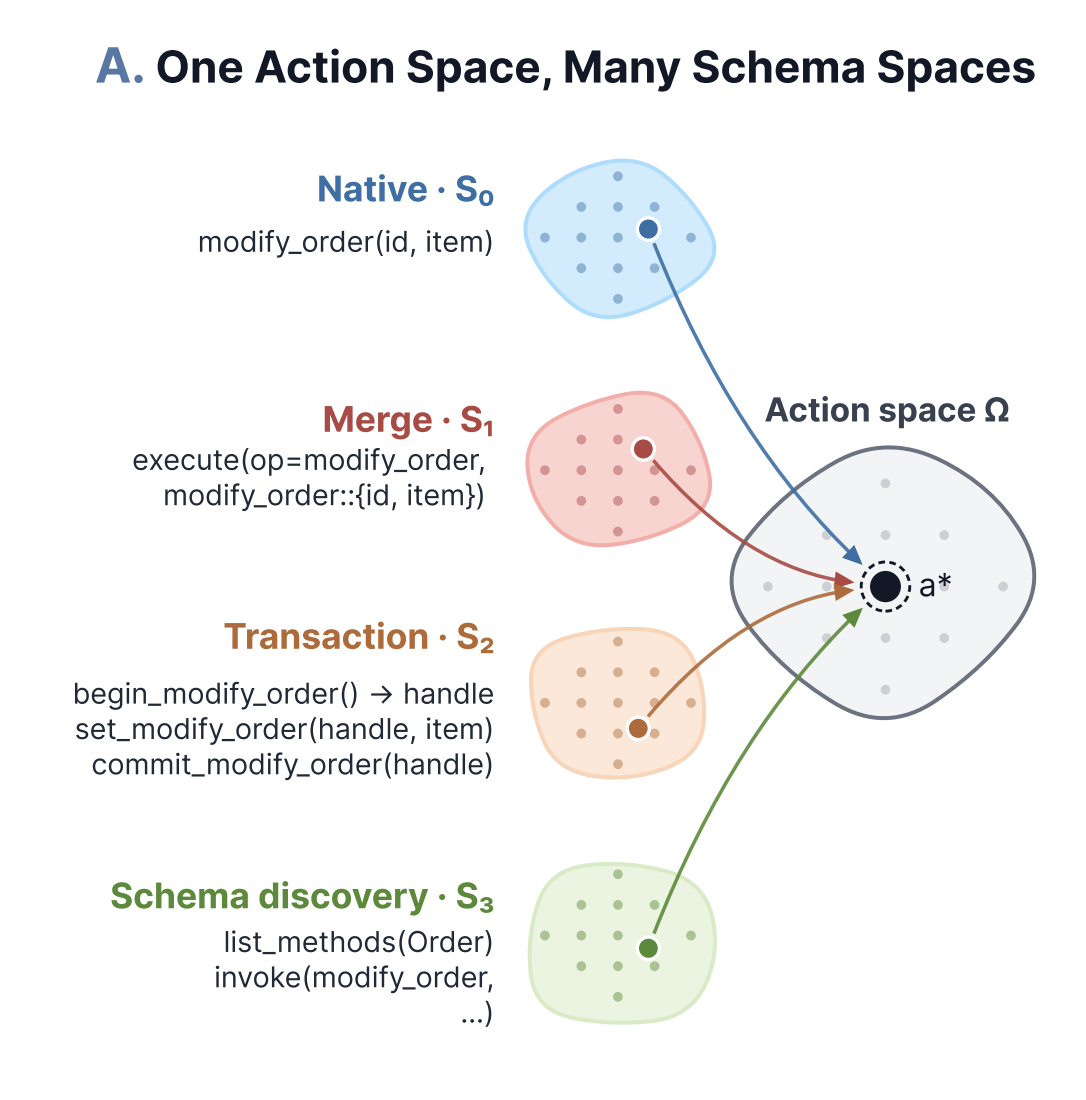
用LLM使用Tool-call 做agent任务已经是现在非常普遍的行为模式和使用场景了。但是往往一个agent环境就是给定一个固定的tool schema,然后不管在评测,还是训练的场景,模型都是针对这一套固定的schema来尝试学习与agent环境交互。然而我们注意到这其中一个有意思的事实:定义一个agent环境的应该是环境内能够具体执行的action space,而tool schema仅仅只是这个action space的一个interface protocol。 而这样的protocol并不唯一,甚至我们可以定义出无限种不同的protocol。
我们认为如果LLM真正理解一个action space,那它的效果不应该被不同interface的representation左右太多。然而经过我们实际的测试,并不出乎意料的,我们发现LLM面对不同interface schema的时候表现并不一致。我们称这个现象为Schema Bias。
同一个动作,不同的说法
举个例子,一个订机票的环境里要把某个预订改签到另一班航班。这个动作可以是一个独立的tool,也可以合并进一个带 action 参数的大tool,还可以拆成 begin / set / commit 三步的transaction:
change_flight(reservation_id="R1", flight="BA117")                  # native

manage_reservation(action="change", reservation_id="R1", flight="BA117")  # merge

flight_change_event_handle = begin_change_flight()                                          # transaction
set_change_flight(txn_id=flight_change_event_handle, reservation_id="R1", flight="BA117")
commit_change_flight(txn_id=flight_change_event_handle)
这三种写法能做的事情完全一样,到达的环境状态也完全一样。Action space 决定了"能做什么",tool schema 只决定了"怎么说"。
而现在主流的 benchmark,比如 τ²-bench(Barres et al. 2025)、BFCL(Yan et al. 2024),每个环境都只给出一套固定的 schema。在强化学习里,动作空间怎么表示会影响学习早已是共识(Kanervisto et al. 2020);但对 LLM agent,这个问题还很少被系统地检验过。
我们做了什么
我们用九种改写方式(合并、拆分工具,改变参数结构,改名,删描述,以及把一次调用拆成多步流程等)构造了最多 32 种 schema 变体,在一个合成 benchmark 和四个真实 benchmark(τ²-bench、BFCL、AutomationBench、MCP-Atlas)上评测了 11 个模型。所有变体下的调用都能还原回原本的动作,任务和环境保持不变,所以分数的变化只来自 schema 本身。
Schema bias 有多大
在各种schema变体下,比如各种聚合,拆分工具,改变参数结构,修改调用流程等等,基本所有模型都会有不同程度的表现劣化。只换 schema,有的模型可以从接近满分直接掉到零,最新的开源模型和闭源模型也不例外。
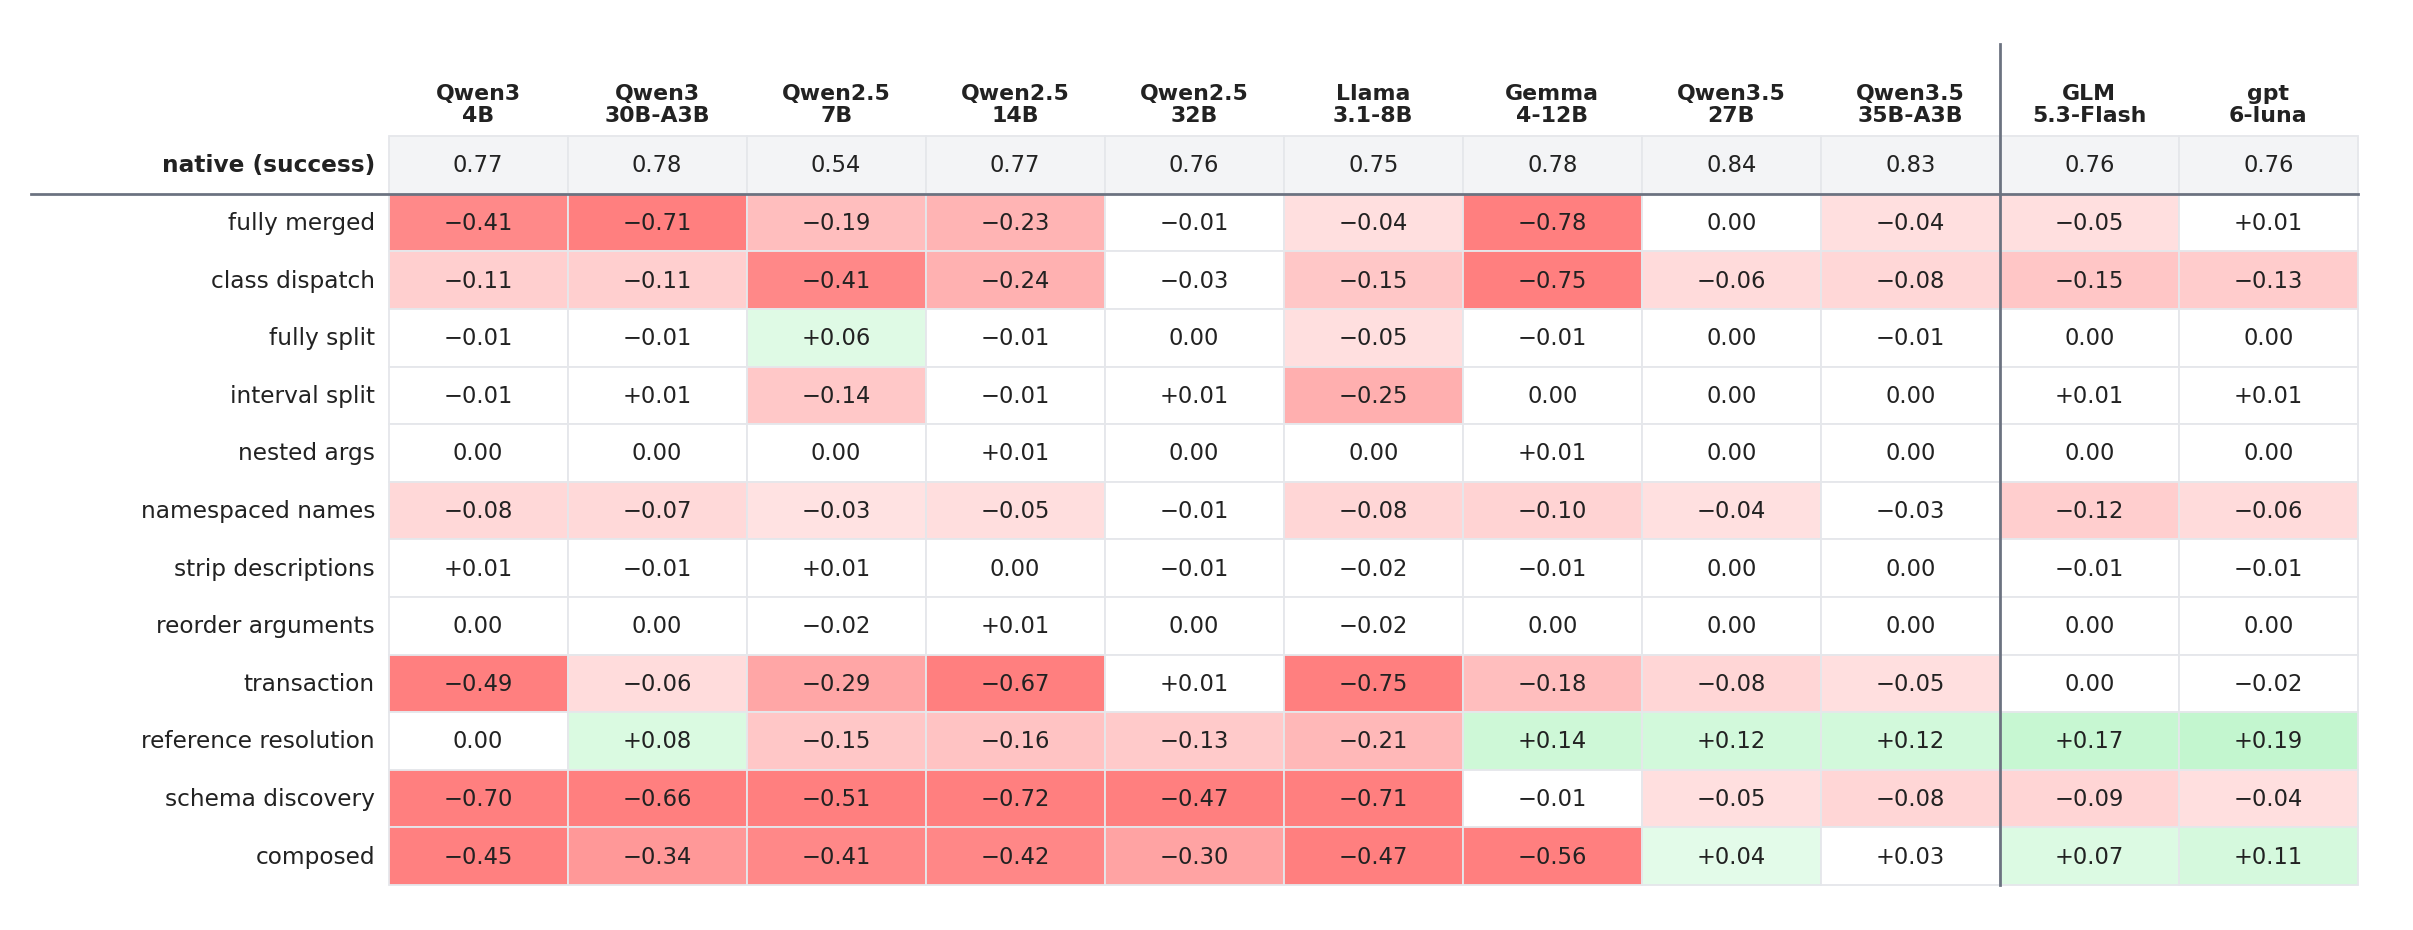
更有意思的是,并不存在一个对所有模型都安全的 schema:某个写法对一个模型几乎无影响,对另一个模型却可能是灾难性的。所以"哪种 schema 最难"本身就是 model dependent 的。
我们能看到不同模型,不同schema结构 展现出独特的失败原因。把失败的 trajectory 拆开看,失败的"形状"往往跟着 schema 走:transaction 下大家都容易 begin 了忘记 commit,合并后的 dispatcher 下大家都容易选错分支,调用被拒后有的模型会反复发同一个错误调用,陷入 livelock。可以说,schema 决定了模型会怎么错,模型决定了会错多少。
能否提前预测
我们要如何预测一个模型的schema bias performance?总不能每换一个schema就把整套评测重跑一遍。由此出发我们想知道这个Bias是模型dependent吗?跟test set的query distribution是否相关?
我们比较了两类 estimator:一类不用真实任务,只看 schema 本身的各种 features(比如工具数量、参数结构),或者模型对正确调用的 likelihood;另一类是从目标任务里抽一小批 query 真的跑一遍。
结论很明确:仅凭 schema 的各种 features,或者模型对它的 likelihood,都无法判断这个 schema 在真实任务里是否困难;而抽几十个目标 query,排出来的难易顺序就已经很接近完整评测。训练之后更是如此,likelihood 和真实表现完全脱了钩,有时甚至是反相关的。
回到开头的两个问题:Bias 是 model dependent 的,同一组 schema 在不同模型上的难易顺序并不相同,所以没法拿一个模型的结果去推另一个;它也和 query distribution 相关,一个 schema 难不难,取决于目标任务具体要模型做什么,只看 schema 本身是看不出来的。所以想估得准,就绕不开真实的 query。
能否缓解
最后我们想知道schema bias是否可以通过训练/非训练的干涉来缓解。
非训练的方法里,在 prompt 里说明调用约定帮助有限;constrained decoding 能修好格式,却修不好语义,模型的调用都合法了,还是会在多步流程里迷路。
训练方面,我们用 native 数据和多种 variant 的混合数据分别做了 SFT 和 RL(GRPO;Shao et al. 2024):
- 只在 native 上训练,bias 基本原封不动;
- 混合数据做 SFT,见过的 variant 变好,但在没见过的 variant 上要交"税";
- 混合数据做 RL,能修好见过的 variant,同时不损失 native 上的表现。
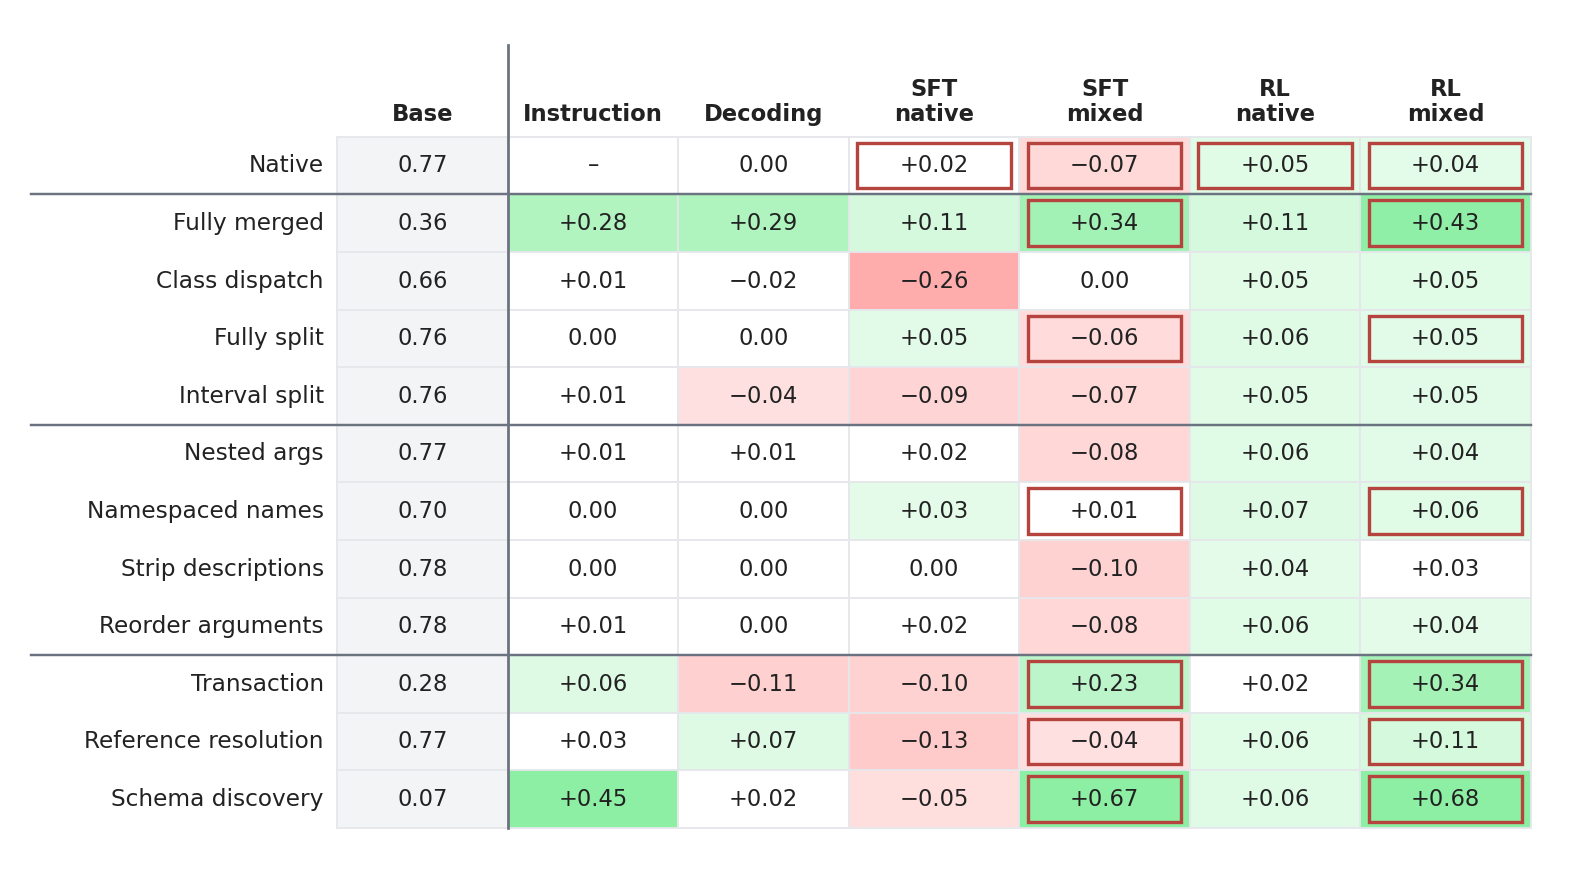
但这种修复的泛化是有边界的:对见过的改写方式的新组合可以迁移,对全新的改写方式则帮助有限。放到真实 benchmark 上也一样,提升基本只出现在训练里见过的那几种 schema 上。训练能修补的,基本就是它见过的东西。
写在最后
只在一套固定 schema 上评测,其实是把"模型会不会做这件事"和"模型习不习惯这种写法"混在了一起。回到开头那个改签的例子:一个真正会改签的 agent,不该因为工具从一个变成三步就不会了。随着 agent 被部署到越来越多不同人设计的工具环境里,interface 的多样性只会越来越大。所以一个很朴素的建议是:下次评测你的 agent 时,不妨换两套等价的 schema 再跑一遍,看看分数还剩多少。
代码、合成 benchmark 和四个真实 benchmark 的 adapter 都已开源:ToolSchemaSpace · Paper
Citation
@article{liu2026actionspace,
  title   = {Action-Space Shaping for {LLM} Agents: Measuring and Mitigating Tool-Schema Bias},
  author  = {Liu, Yinhong and Tan, Zhili and Wang, Zilin and Guo, Zhijiang},
  journal = {arXiv preprint arXiv:2609.34971},
  year    = {2026},
  url     = {https://arxiv.org/abs/2609.34971}
}
References
[1] Barres et al. "τ²-bench: Evaluating Conversational Agents in a Dual-Control Environment." arXiv:2506.07982 (2025).
[2] Yan et al. "Berkeley Function Calling Leaderboard." (2024).
[3] Kanervisto, Scheller and Hautamäki. "Action Space Shaping in Deep Reinforcement Learning." IEEE Conference on Games (2020).
[4] Shao et al. "DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models." arXiv:2402.03300 (2024).